DeepSeek私有化部署火了,跨境电商选GPU租赁显卡要花多少钱?
为什么今年选卡逻辑变了:从「能跑就行」到「算得清账」
过去跨境电商团队租GPU,多数是为了跑 Stable Diffusion 出主图、做短视频素材,一张 8G 显存卡能用就行。今年情况变了:DeepSeek、Qwen、Llama 这类开源模型可以在中小团队私有化部署,很多卖家想自建 AI 客服、把商品资料和售后话术做成 RAG 知识库,再顺手批量生成投流素材。需求从「单次出图」变成「7×24 在线推理」,选卡的第一判断标准也就从算力转向显存,从单卡性能转向并发与首字延迟。
对跨境电商来说,这件事的真实痛点是时区:欧美客户在夜里提问,客服响应慢就直接丢单。首字延迟(用户发出问题到看到第一个字的时间)超过 2 秒,体验就明显下降;而延迟主要由模型大小、显存带宽和并发排队共同决定,不是买张贵卡就能一劳永逸。
显存怎么算:先定模型,再定并发
显存占用一般由三部分组成:模型权重、KV Cache(上下文缓存)、框架与显存碎片预留。一个粗略的通用量级是:FP16 精度下,权重约占「参数量 × 2GB」;做 4bit 量化后通常降到四分之一左右。比如 7B 模型 FP16 约需 14GB 权重,4bit 量化后约 4~5GB,加上上下文缓存和预留,单路 8G 卡可以勉强跑起来,但并发一多就会排队。
KV Cache 随并发数和上下文长度线性增长。以 7B 模型、4K 上下文为例,单路缓存通常在几百 MB 量级,10 路并发就要额外预留数 GB。实操建议按以下清单逐项对照:
- 模型参数量与量化精度(决定权重显存下限)
- 预期峰值并发数(同时在线提问的会话数,不是日活)
- 上下文长度(商品详情、历史对话越长,缓存越大)
- 是否需要同时跑向量库、OCR、图片生成(会挤占同一张卡)
- 留 20%~30% 显存余量,避免碎片导致 OOM
经验判断:7B 量化模型做客服问答,16G 显存卡可支撑个位数到十几路并发;要到几十路并发,通常需要 24G 及以上显存,或改用多卡并行、把请求排队做削峰。
首字延迟与并发:带宽和卡型谁更关键
首字延迟由预填充阶段决定,和显存带宽、卡的计算能力关系最大;后续出字速度则受显存带宽和批处理策略影响。老架构的入门卡(如 GT740、GT750 级别)显存只有 2~4G,跑现代大模型基本不现实,更适合做轻量图像处理、老版本小模型或渲染辅助。1050 Ti 这类 4G 卡可以跑量化后的小参数模型做测试,但并发和上下文都很受限。
真正要跑在线推理,24G 显存级别的卡是更现实的起点;预算紧张时,可以用「云 GPU 按量计费做峰值 + 物理机包月跑常驻服务」的混合方案。地区选择上:面向欧美客户,硅谷节点到用户链路更短;面向东南亚与国内团队协作,香港节点延迟和网络可达性更均衡,具体线路质量视服务商而定。
成本账:云 GPU 按量 vs 物理机包月
把花销拆开看,主要有四块:显卡租金、带宽、存储、运维人力。
- 云 GPU 按量:适合验证期和流量波峰,按小时计费,不用时关掉,但长期 7×24 跑下来总价通常高于包月,且数据落在共享环境,合规上要多看一眼。
- 物理机包月:适合客服、知识库这类常驻服务,成本可预测。入门级带显卡的物理服务器月付在百元到数百元量级,中高端 24G 卡机型则要上千元甚至更高,视卡型与带宽而定。
- 带宽:推理服务的出口流量不大,但图片、视频素材生成与分发会吃带宽,10M 与 100M 的差别在批量出素材时非常明显。
- 运维:自建要有人管驱动、模型更新和监控,小团队通常把这部分折算成人力成本。
避坑要点:一是别被「大显存」宣传误导,要确认是单卡独享还是共享;二是问清带宽是独享还是峰值;三是确认能否按月退订,避免验证失败被年付锁死;四是涉及海外用户数据,提前确认机房所在地区的合规要求。
选购推荐
结合跨境电商的真实节奏,建议先用低门槛机型做小模型与素材生成验证,再按并发增长升级。秀米云在售机型里,两款比较贴合本文场景:
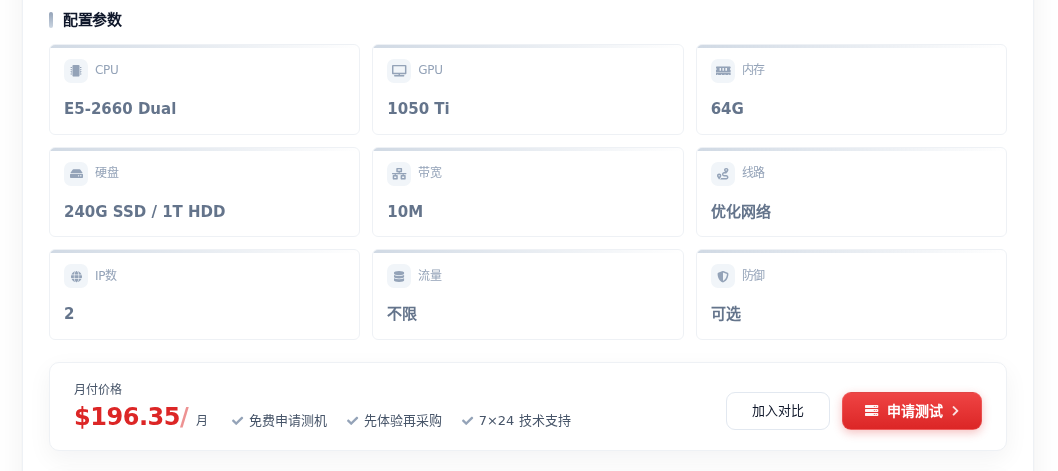
如果主要做商品图批量处理、跑轻量量化模型做内部测试,香港显卡物理服务器2*E5-2660(1050 Ti) 配 64G 内存和 1050 Ti,月付 196.35 元,香港节点对东南亚与国内团队协作更友好,适合先跑通流程再谈扩容。
如果面向欧美客户、需要更充足带宽做素材分发与模型下载,硅谷GPU服务器 IV 配 1080 显卡、双 E5-2680、32G 内存与 100M 带宽,月付 748 元,硅谷节点到欧美用户链路更短,适合作为常驻推理与素材生成的过渡机型。
决策建议
先按「模型参数量 + 峰值并发 + 上下文长度」算出显存下限,再留三成余量;首字延迟优先看显存带宽和卡型代际,别只看核心数。验证期用按量云 GPU 压测真实并发,稳定后再转物理机包月,把成本锁在可预测区间。跨境电商的AI投入不必一步到位,先让客服和素材两条线跑通,再根据排队情况加卡,是最不容易踩坑的路径。