矩阵站群跑批量AI内容,GPU租用和物理机包月要多大显存才够?
做矩阵站群的团队通常会遇到同一个瓶颈:几十上百个站点要持续产出标题、摘要、伪原创、多语言改写和配图描述,人工写不动,纯API按token付费又会在量上来后失控。于是问题变成——到底是租云GPU按量跑,还是直接包一台带显卡的物理机?显存要多大才够同时跑几个任务?三年下来哪种更省?这篇按可执行步骤拆开讲。
第一步:先算清显存与并发,别凭感觉选卡
显存决定能装下多大的模型,并发决定要几张卡。矩阵站群的真实负载一般不是长文创作,而是短文本批量生成(标题、meta描述、产品卖点改写)加少量RAG问答,单次输出多在200~800 token之间,这类场景对显存的要求比想象中低,但对并发吞吐更敏感。
- 7B~8B模型(Qwen、Llama系列小参数版本)4bit量化后通常占4~6GB显存,8GB卡可跑但并发很低,16GB是较舒服的起步线。
- 14B级模型4bit量化一般需10~14GB,建议24GB显存起步。
- 32B级模型4bit量化普遍在20GB以上,需双卡或48GB级显存。
- 并发估算的通用口径:单张24GB卡跑8B量化模型,短文本场景通常能支撑5~15路并发;显存每翻一倍、模型不变时,并发大致同比例上升,但会被显存带宽和CPU预处理拖后腿。
判断标准很简单:先按「同时跑几个站点的生成任务」定并发,再按「用哪个参数量的模型」定显存,最后才看算力。矩阵站群多数情况下瓶颈在并发排队,而不是单次生成速度;首字延迟(TTFT)主要受显存带宽与模型加载方式影响,租用共享GPU时邻居争抢会让延迟波动明显,这也是物理机包月的核心价值之一。
第二步:云GPU按量与物理机包月,账怎么算
市场行情量级上,云端按量GPU(24GB级消费卡或同级专业卡)单价通常在每小时几元到十几元区间,包月折算常见在每月一两千元到数千元;带显卡的物理机包月,入门级(GT740、1050Ti这类老卡)可低至一百多元到两百元每月,中端(1050、1080级)多在两百到八百元每月,专业卡机型则明显更高。视服务商与线路而定,价格浮动很大。
三年成本对比的关键不在单价,而在利用率:
- 日均实际跑满不足4小时,按量租用更划算,且不用承担硬件老化和运维。
- 矩阵站群常是7×24定时批量生成、夜里跑全量改写,日利用率轻松超过8小时,包月物理机的边际成本会迅速低于按量。
- 按量方案容易忽略的隐性成本:对象存储、出网流量、快照、以及任务排队导致的工期延长。
- 物理机包月的隐性成本:显卡代际老、驱动与CUDA版本要自己维护,出故障只能等服务商换件。
实操建议是先用按量GPU跑两周真实任务,记录峰值并发、日均GPU小时和单位任务耗时,再拿这组数据去反推包月机型,避免拍脑袋。
第三步:地区、线路与合规,矩阵站群最容易踩的坑
GPU服务器不是随便挑个地区就行,站群业务对IP纯净度和访问稳定性更敏感:
- 香港:到内地延迟低,适合需要频繁从内地管理后台操作、又要面向海外搜索引擎的场景;国际带宽普遍偏小,10M档位常见,批量拉取素材要控速。
- 硅谷:国际带宽通常给得宽(100M档常见),适合面向欧美流量、需要大文件传输与多站点抓取的场景,但内地直连延迟高,运维体验差一些。
- 日本、新加坡:介于两者之间,适合东南亚与东亚混合流量,具体看服务商回程线路。
- 合规:做AI生成内容出海,需关注目标市场对AI内容的标注要求与数据出境规则,模型权重与用户数据不要混放在同一台对外站点机器上。
避坑要点:一是别把「显卡型号老」当成不能用,GT740、1050Ti这类卡跑量化小模型做短文本批量生成完全够用,价格却低一个量级;二是确认是否独享GPU,共享卡在高峰期延迟会翻倍;三是问清带宽是独享还是峰值共享,站群并发抓取时差别很大;四是老卡注意CUDA版本上限,选型前先确认要跑的推理框架是否还支持。
选购推荐:按站群真实负载对号入座
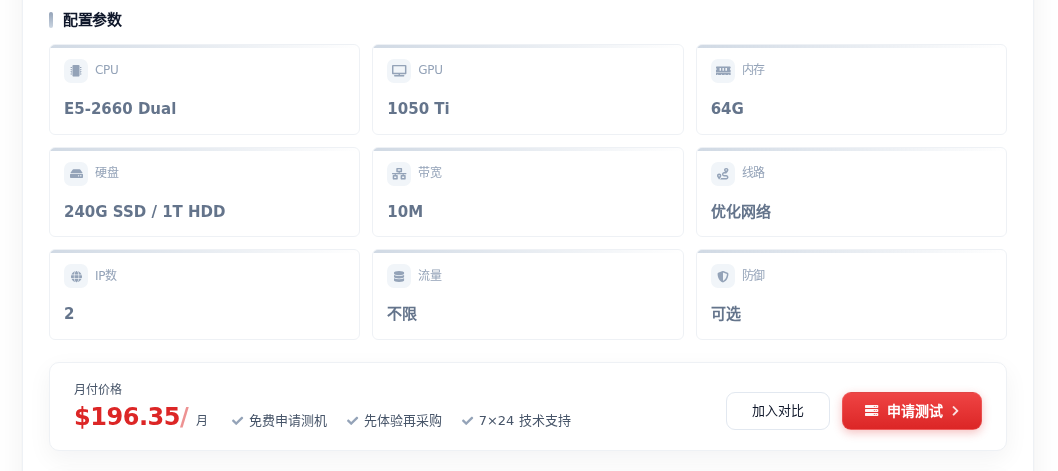
如果团队是「几十个站点、短文本批量生成、预算敏感」的典型矩阵站群,建议先从入门级显卡物理机起步,把并发和任务队列跑通再加机器。香港线路里,香港显卡物理服务器2*E5-2660(1050 Ti)配64G内存、240G SSD加1T HDD、10M带宽,196.35元/月,双路E5加1050 Ti的组合跑8B量化模型做标题与描述改写比较从容,低延迟也方便内地后台管理,适合作为主力生成节点。
如果主要面向欧美流量、需要更大带宽拉素材和同步多站点内容,硅谷线路更合适,硅谷GPU服务器 II(1050 / E5-2620*2 / 32GB / 1T SSD / 100M带宽)199元/月,100M带宽在批量抓取与多站同步时优势明显,32G内存跑中小参数模型加RAG检索也够用,适合作为出海站群的批量任务机。
决策建议:先用按量GPU测两周真实并发与GPU小时,日利用率超过8小时就转物理机包月;显存按模型参数量卡位,7B~8B量化从16GB起、14B从24GB起;地区按流量去向和运维习惯选,香港重延迟、硅谷重带宽;老卡不等于不能用,先确认框架兼容再下单。