从0到1:SEO站群团队如何用云GPU与物理机算三年成本账
一个做矩阵站群的SEO团队,手头运营着几十个内容站,过去靠人工改写和外包写手,每月内容成本压不下来。引入开源大模型做批量内容生成后,问题从“写不出”变成了“算力怎么买才不亏”:云GPU按量计费灵活但单价高,物理机包月便宜但怕闲置。这笔三年账到底怎么算,下面按实际落地过程拆解。
第一步:先算清楚需要什么卡,别急着比价格
站群内容生成属于典型的轻量AI推理场景,不是训练。团队用Qwen或Llama系列7B~14B量化模型做批量文章初稿,配合RAG检索自有素材库。这类任务的核心瓶颈是显存和并发时的首字延迟,不是算力峰值。
- 7B模型4bit量化后显存占用约5~6GB,加上上下文缓存,单卡8GB显存可跑但并发很低;
- 14B模型4bit量化约需9~11GB,建议单卡16GB起步;
- 若做RAG知识库,向量检索本身吃CPU和内存,检索库规模到百万级文档时,内存建议32GB以上。
站群团队常见的并发量是每天几百到几千篇初稿,按每篇2000字、生成速度20~40 token/s估算,一张16GB显存的卡配合合理批处理,日产能通常够用。先按这个量级选卡,再谈租还是买。
第二步:云GPU按量与物理机包月的三年账怎么摆
云GPU按量计费的优势是随开随停,适合模型调试期和流量不确定的起步阶段。市场行情上,单卡16GB级别的按量实例,每小时费用通常在几元到十几元区间,视服务商和地区而定。如果每天跑8小时、每月22个工作日,月支出容易到千元级;连续跑满一个月则更高。
物理机包月则是固定成本。以入门级GPU物理服务器为例,月付通常在百元到数百元区间,三年总支出可以提前锁定。关键在于利用率:如果站群内容生产是每天稳定跑,物理机的单位算力成本会明显低于按量;如果只是每周集中跑一两次,按量反而更省。
实操判断标准可以简化成一条:月均使用时长超过约150~200小时,物理机包月开始有成本优势;低于这个数,按量更灵活。站群团队内容生产往往是持续性的,这条线很容易跨过。
第三步:落地部署与踩坑清单
确定用物理机后,部署流程并不复杂:选带GPU的独立服务器,装好驱动和推理框架(如Ollama或vLLM),把模型权重和素材库放本地盘,用内网或API对外提供生成服务。站群团队通常会把生成任务队列化,夜间批量跑,白天人工审核。
踩坑点集中在几处:
- 显存买小了:只按7B模型选8GB卡,后续换14B或加长上下文就卡住,建议留一档余量;
- 带宽忽略:站群发布内容要频繁上传到各站点后台,物理机带宽太小会拖慢整体流程,10M~100M带宽视发布频率选;
- 地区选错:面向国内访问的站点,香港机房延迟低、线路稳;面向海外独立站,硅谷机房更贴近目标用户。不要只看价格,线路质量直接影响发布效率;
- 把训练需求当推理买:站群内容生成基本是推理,不需要高算力训练卡,买贵了是浪费。
另外,物理机包月要确认服务商是否允许长期占用GPU、是否支持重装系统、故障响应时效如何,这些比参数表更影响三年总体验。
选购推荐
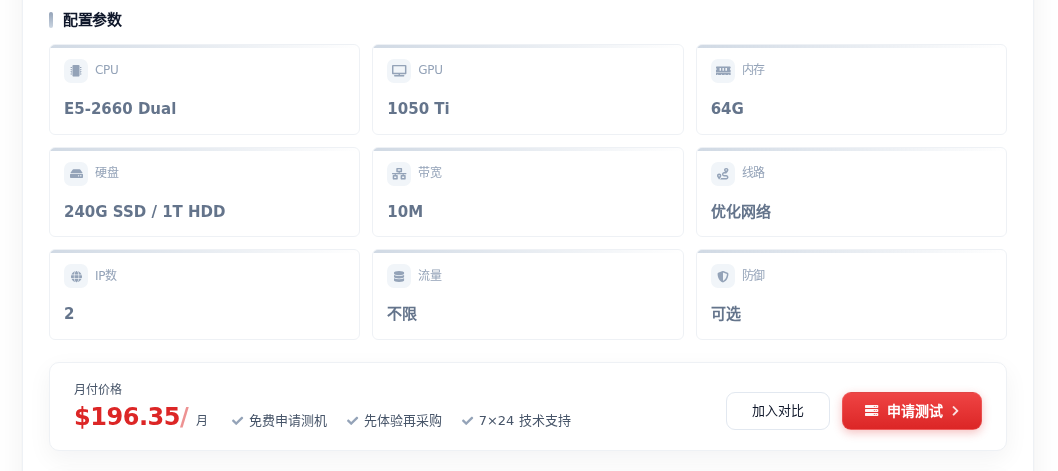
对站群SEO团队这类轻量推理场景,不必追高配。秀米云在售机型中,香港显卡物理服务器2*E5-2660(1050 Ti)配置为GPU 1050 Ti / 双E5-2660 / 64G内存 / 240G SSD+1T HDD / 10M带宽,196.35元/月,64G内存对RAG素材库和批量任务队列比较友好,香港机房对国内站点发布延迟低,适合作为站群内容生成的主力机。若主要面向海外独立站,可考虑硅谷GPU服务器 II,GPU 1050 / 双E5-2620 / 32GB / 1T SSD / 100M带宽,199元/月,100M带宽在批量上传和海外访问上更有余量。两款都是包月固定成本,按前述150~200小时的使用门槛,站群团队的持续生产很容易跑过这条线,三年账算下来比按量更可控。
总结一句:先用按量把模型和流程跑通,测算真实月使用时长;跨过150~200小时门槛后,转物理机包月锁定成本,选卡留一档显存余量,地区按目标站点选香港或硅谷,带宽别省。这样三年算力账才不容易亏。