GPU算力租赁怎么选卡:跑Qwen推理的显存与并发成本实测账
先算显存:跑Qwen到底要多大卡
Qwen系列常见7B、14B、32B、72B几个量级,推理显存占用主要看模型权重精度和上下文长度。行业通用估算:FP16精度下每1B参数约需2GB显存,INT8约1GB,INT4约0.5GB。实际部署还要预留KV Cache和框架开销,通常按权重的1.2~1.5倍估算总显存。
- Qwen-7B:INT4量化约6~8GB,INT8约10~12GB,FP16约16~20GB。单卡24GB(如3090/4090)可跑FP16,单卡16GB建议INT8。
- Qwen-14B:INT4约12~16GB,INT8约20~24GB,FP16约32~40GB。24GB卡跑INT8比较稳,FP16需双卡或A100 40GB。
- Qwen-32B:INT4约24~32GB,INT8约40~48GB,FP16约64~80GB。单卡48GB(如A6000)可跑INT4,FP16建议双卡80GB。
- Qwen-72B:INT4约48~64GB,基本需要80GB单卡或双卡并行,中小团队不建议自建。
注意,显存不是唯一门槛,显存带宽决定首字延迟和吞吐。消费卡(4090)带宽约1TB/s,专业卡(A100)约2TB/s,同样模型专业卡首字延迟通常低30%以上。如果业务对首字延迟敏感(如客服对话),优先选高带宽卡。
并发成本账:云GPU按量 vs 物理机包月
并发能力取决于显存余量和计算吞吐。以Qwen-7B INT4、24GB卡为例,单卡通常可支撑10~20路并发(每路上下文2K),首字延迟约200~500ms。若日均请求1万次、每次平均500 token输出,单卡基本够用;若峰值并发超过20路,需考虑多卡或排队。
成本对比按市场行情量级:
- 云GPU按量:RTX 4090单卡约2~4元/小时,A100 40GB约8~15元/小时。适合短期测试、流量波动大的场景,但长期跑满一个月成本可能过万。
- 物理机包月:消费卡整机(如1050 Ti/750)月租百元级,但显存小、算力弱,只适合7B以下量化模型或轻量推理;专业卡整机(如A6000)月租数千元级,适合稳定高并发。
- 多IP与线路:香港机房对内地延迟低(CN2线路约30~50ms),硅谷机房国际带宽充足但内地访问延迟150ms+。若面向海外用户,硅谷更合适;面向内地用户,香港优先。
关键判断:月均GPU利用率超过40%时,物理机包月通常比按量更划算;低于20%则按量更灵活。中小团队可先用按量云GPU做压力测试,摸清真实并发和显存占用,再决定是否包月。
选型清单与避坑要点
对比参数时,除了显存和价格,还要盯住这几项:
- 显存类型与带宽:GDDR6 vs HBM2,带宽差一倍以上,直接影响首字延迟。
- CPU与内存:推理服务需要CPU做预处理,建议不低于8核、内存不低于显存2倍。
- 带宽与流量:API服务出口带宽建议10M起步,海外机房100M更从容;注意是否限制月流量。
- 线路质量:香港CN2线路对内地友好,硅谷BGP国际线路适合全球分发。测试时用ping和traceroute看延迟抖动。
- 是否支持GPU直通:物理机需确认GPU直通无虚拟化损耗,云GPU注意是否共享算力。
常见坑:只看显存不看带宽,结果并发一上来首字延迟飙升;用消费卡跑FP16大模型,显存爆掉被迫降精度,效果打折;忽略机房线路,内地用户访问硅谷机器延迟高,客服场景体验差。建议先租按量实例跑一轮真实流量压测,再签包月。
选购推荐
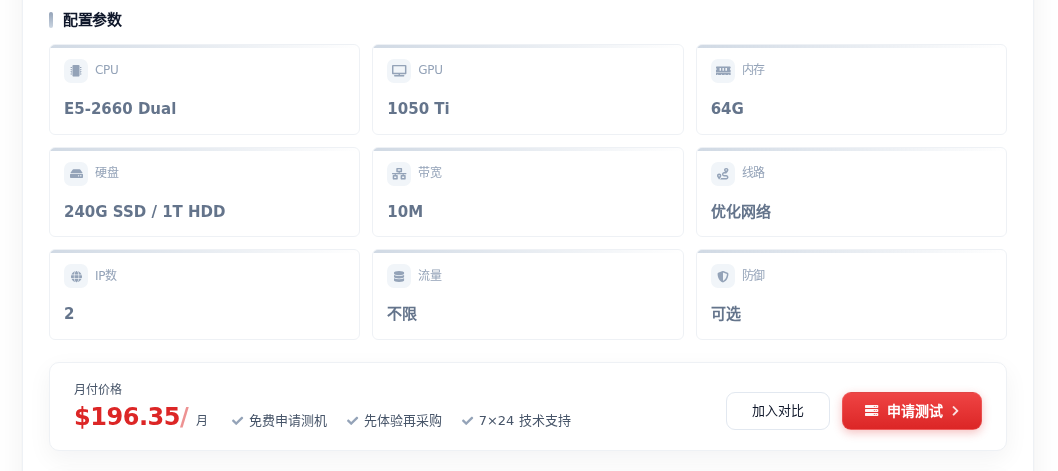
结合中小团队跑Qwen推理的实际需求,如果模型在7B~14B量化版、并发需求中等,且用户主要在内地或亚太,推荐考虑香港显卡物理服务器2*E5-2660(1050 Ti),配置GPU 1050 Ti / 双路E5-2660 / 64G内存 / 240G SSD+1T HDD / 10M带宽,月租196.35元,香港显卡物理服务器2*E5-2660(1050 Ti)。1050 Ti 4GB显存适合Qwen-7B INT4量化推理,64G内存和双路CPU能撑住预处理开销,香港线路对内地延迟友好,适合AI客服、RAG知识库等轻量场景。
如果面向海外用户或需要更大带宽做API分发,硅谷GPU服务器II是更均衡的选择:GPU 1050 / 双路E5-2620 / 32GB内存 / 1T SSD / 100M带宽,月租199元,硅谷GPU服务器II。100M国际带宽适合海外访问,1T SSD保证模型加载速度,适合独立站AI客服、出海SaaS的推理后端。两款都建议先跑压测再决定是否升配到专业卡。
决策建议:先按显存公式锁定模型精度和卡型,再用按量云GPU跑一周真实流量,测出单卡并发上限和首字延迟,最后按利用率是否超40%决定包月还是继续按量。线路跟着用户走,内地优先香港,海外优先硅谷。