GPU算力租赁怎么选:云GPU按量计费与物理机包月三年成本落地指南
做外贸的团队最近常遇到同一个场景:客户邮件要用 AI 批量写多语种回复,产品图要用 AI 生成素材投 TikTok Shop,独立站想接一个 RAG 知识库客服,再顺手跑个 DeepSeek 或 Qwen 的小参数模型做翻译润色。问题不在于要不要用,而在于算力怎么租——云 GPU 按量计费点一下就开,物理机包月看着便宜,三年下来到底谁更划算?这篇按步骤把账算清楚。
第一步:先算需求,别急着比价格
选型前必须先回答三个问题,否则任何报价都没有意义。
- 跑什么模型、多大参数。7B 级别模型做推理,量化后显存一般要 8~16GB;14B~32B 通常要 24~48GB;再大就要多卡。AI 绘画、数字人、短剧译制对显存和算力要求又不一样,视频类更吃持续算力。
- 并发和首字延迟。外贸客服场景一般同时在线咨询不多,5~20 路并发是常见量级;首字延迟希望控制在 1~3 秒内,显存不足会直接触发排队或降级。按「显存 ≈ 模型权重 + KV Cache × 并发」粗略估算,再留 30% 余量。
- 带宽和地区。面向欧美客户,硅谷节点回源快;面向东南亚和国内团队协作,香港节点延迟更友好。跨境业务还要考虑数据合规,客户数据落在哪个司法区,往往比省几百块更重要。
第二步:云 GPU 按量 vs 物理机包月,三年账怎么算
云 GPU 按量计费的优点是弹性:忙时开、闲时关,适合项目制、验证期和流量波动大的团队。缺点是单价高,长期 7×24 跑,月账单通常是同档物理机的数倍;而且云上高端卡经常缺货,配额申请视服务商而定。
物理机包月的逻辑相反:固定月费、独享显卡、带宽和 IP 稳定,适合已经跑通业务、需要长期在线的场景。三年周期里,物理机的总成本一般明显低于持续按量的云 GPU,但要承担闲置风险和硬件老化。
判断标准可以简化成一条:每月实际满载运行超过 300 小时,优先考虑物理机包月;低于 100 小时,按量更划算;中间区间看业务是否稳定增长。另外别忘了把公网带宽、独立 IP、备份和运维人力算进总账,很多报价只写了 GPU 单价。
第三步:配置清单与避坑要点
对比服务商时,建议逐项打勾:
- 显卡型号与显存容量,是否独享而非共享;
- CPU 核数、内存与显存是否匹配(内存一般不低于显存的 2 倍);
- 系统盘是 SSD 还是 HDD,模型加载速度差别很大;
- 带宽大小、是否含独立 IP、流量是否限速;
- 机房地区、线路类型(CN2/BGP/国际带宽)与到目标市场的实测延迟;
- 是否支持按天或按月切换、能否升级显卡;
- 数据合规与备份策略,尤其是涉及海外客户信息时。
常见坑:只盯显卡不看带宽,模型跑得快但客户访问慢;把共享显卡当独享买;忽略内存和硬盘,加载大模型时频繁换页;以及被「无限流量」话术吸引,实际有峰值限制。
选购推荐:从入门验证到稳定承载
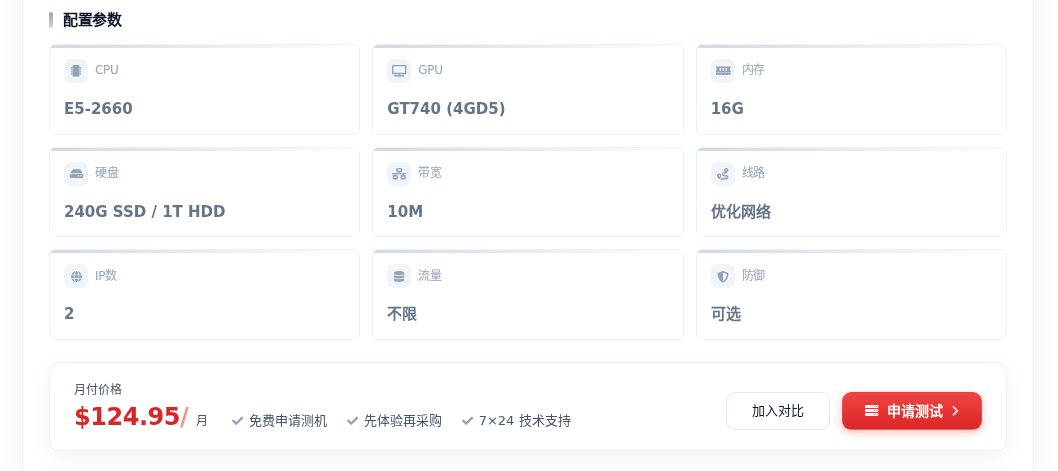
如果是第一次把 AI 客服或 AI 素材生成跑起来,建议先用一台低成本的显卡物理机做验证,跑通流程再扩。香港显卡物理服务器 E5-2660 配置为 GT740 4G 显存、16G 内存、240G SSD 加 1T HDD、10M 带宽,月费 124.95 元,适合做轻量推理、图片处理和跨境办公辅助,香港节点对东南亚和国内团队都友好,可以先看这款入门机型。
如果业务已经稳定,需要更大显存和更强并行能力来跑 7B~14B 模型或多路并发,硅谷 GPU 服务器 III 配 AMD WX 7100、双路 E5-2683v4、64GB 内存、1T SSD、100M 带宽,月费 579 元,面向欧美客户时硅谷节点延迟更有优势,适合作为长期承载机,可参考硅谷 GPU 服务器 III。两款都建议先按月租用观察一两个月负载,再决定是否长期锁定。
决策建议:先用按量云 GPU 或低价物理机验证模型和并发,确认每月满载时长超过 300 小时后再转物理机包月,三年总成本通常更可控;带宽、显存和地区三项必须同时满足,缺一项都会在真实业务里返工。