大模型推理三年要花多少钱:GPU算力租赁与物理机包月怎么选
一个做家居跨境的十来人体量团队,去年想把客服问答做成 RAG:私有化跑 Qwen 7B 量化版,接自己的产品库和售后工单。开发两周就跑通了 Demo,真正卡住的是第二个月——按量计费的云 GPU 账单在咨询高峰期一周就冲到四位数,运维负责人开始算一笔账:这套东西要用三年,到底是继续租卡,还是包一台物理机?
下面按这个案例的复盘顺序讲:先算显存和并发,再算两种模式的三年成本,最后说清怎么选、会踩什么坑。
第一步:先算清显存与并发,别急着比价格
大模型推理的机器选型,顺序永远是显存 → 算力 → 带宽 → 硬盘,而不是反过来。经验量级:7B 模型做 4bit 量化,权重约占 4~5GB,加上 KV Cache 和框架开销,单卡 12~16GB 显存可以比较从容地支撑个位数到十几路并发;13B~14B 量化后权重 8~9GB,通常建议 24GB 显存起步;32B 级别量化后往往要 24GB 以上甚至双卡。并发不是靠猜,用压测工具按真实提问长度跑一遍,记录首字延迟(TTFT)和每秒输出 token 数,这是后面所有成本对比的基准。
还要区分两类负载:一是客服问答这种「白天高峰、夜间几乎空闲」的波峰波谷型;二是短剧译制、AI 投流素材批量生成这类「跑批几小时、平时不用」的离线型。前者对稳定性敏感,后者对单价敏感,选型逻辑完全不同。
另外提醒一点:很多中小团队最后发现瓶颈不在 GPU,而在知识库检索和网络。RAG 的向量检索、文档解析很吃 CPU 和内存,海外用户访问还要考虑线路。所以对比方案时,要把「GPU + CPU + 内存 + 带宽 + 硬盘」打包看,而不是只比一张卡的小时价。
第二步:三年成本怎么摊,两种模式的真实差别
GPU 算力租赁(按量/包月租卡)的优势是弹性与免运维:忙时加卡、闲时释放,驱动、CUDA、故障都由平台兜底。代价是单价高,且长期占用的折扣有限;对波峰明显的业务友好,对 7×24 常驻服务就不划算。按市场行情量级,主流 24GB 级推理卡的按量价格通常在每小时个位数到十几元区间,包月租卡则视显存和平台而定,一般在一两千元到数千元每月不等,具体以服务商报价为准。
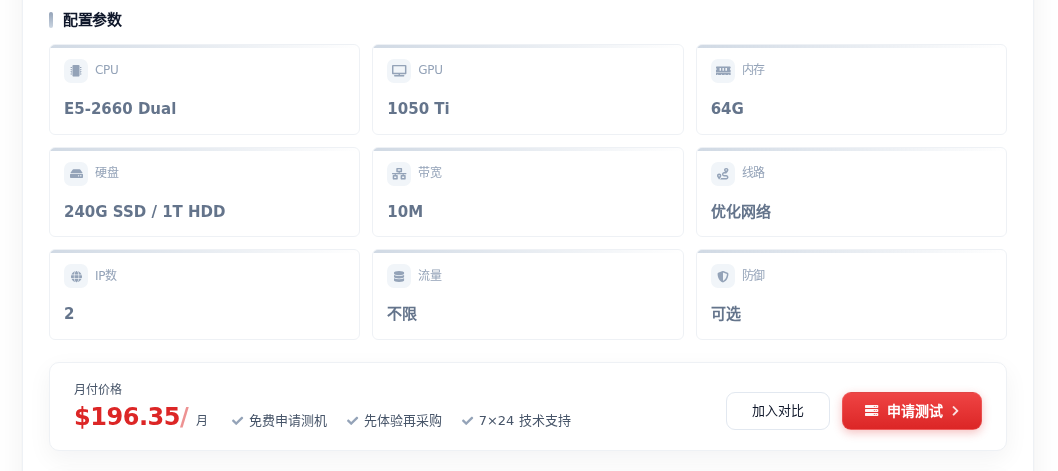
物理机包月的优势是成本可预期:一台机器固定月付,跑满不额外计费,适合常驻推理和批量任务。代价是闲置也照付,且需要自己处理系统、驱动、监控和故障。以本站合作商家秀米云的入门显卡物理机为例,香港机房带 GT740 4G 显存的机型在百元级月付,带 1050 Ti 的机型在两百元级;硅谷机房带 1050、1080 的机型分别在一百多元和七百多元每月。这类机器适合小模型推理、开发测试、OCR/图像预处理等轻负载场景,跑 7B 以上大模型则显存明显不够。
把三年摊开看,结论通常是这样:如果推理服务 7×24 常驻、日常 GPU 利用率能到三成以上,物理机包月的三年总成本往往低于同等规格的长期租卡,且账单可预测;如果利用率长期低于一两成、或者有明显季节性,租赁更省钱。中间态业务常见做法是「物理机扛基线流量 + 高峰期临时租卡」,这个组合在中小团队里落地效果最好。
第三步:落地步骤与容易踩的坑
- 压测定基线:用真实问题集跑出单卡可承载的并发与 P95 首字延迟,留 30% 余量。
- 按利用率分档:日均 GPU 利用率高于三成走包月,低于两成走按量,季节性业务做混合。
- 选地区看用户在哪:面向内地用户优先香港等低延迟节点;面向欧美用户选硅谷等机房更贴近;同时确认线路类型(CN2/BGP/国际带宽)与是否含 DDoS 基础防护。
- 确认交付细节:是否给 root、能否自行装驱动与容器、带宽是独享还是共享、超流量怎么计费、能否加硬盘。
- 留好迁移路径:模型权重与向量库放在对象存储或独立数据盘,避免换机器时重做一遍。
常见坑:只看显卡型号不看显存位宽与代际;忽略带宽,10M 带宽下模型权重下载和对外 API 都会很难受;把开发测试机直接当生产用,没有监控和重启策略;以及最典型的——按量租卡忘记设预算告警,一个月账单翻几倍。
选购推荐
回到案例本身:如果只是先验证 RAG 流程、跑 7B 以下量化模型和小批量图像预处理,没必要一上来就上高配。秀米云的香港显卡物理服务器 2*E5-2660(1050 Ti),64G 内存、240G SSD 加 1T HDD、10M 带宽,196.35 元/月,双路 CPU 对文档解析和向量检索比较友好,香港节点对内地与东南亚访问延迟也更稳,适合作为私有化知识库的第一台常驻机。若业务主要面向欧美用户、需要更大带宽做素材分发或批量推理,硅谷 GPU 服务器 IV(1080),32G 内存、1T SSD、100M 带宽,748 元/月,显存和带宽都更宽裕,适合跑轻量模型服务与 AI 素材生成这类偏吞吐的任务。两者都属于包月固定成本,配合高峰期临时租卡,就是前面说的混合方案。
决策建议:先用按量租卡把压测和基线跑出来,拿到真实的并发与利用率数据;常驻服务且利用率过三成,转物理机包月把成本锁死;波峰波谷明显的,用一台入门物理机扛基线、忙时再租卡。三年账算下来,省钱的往往不是单价最低的方案,而是最贴合自己负载曲线的那一种。